| 软件名称 | colibrì(读作”科利布里”,蜂鸟) |
| 版本 | v2.0.0(以 GitHub Release 页为准) |
| 适用平台 | Windows / Linux / macOS,最低 8GB 内存 + 22GB 磁盘 |
| 核心功能 | 在普通电脑上本地运行千亿参数级开源大模型,数据不出本机 |
| 授权 | Apache 2.0,免费开源 |
| 难度 | 简单(Windows 上下载解压、双击一个 bat 文件即可) |
| 项目地址 | https://github.com/JustVugg/colibri |
前言
先问个问题:想在自己电脑上跑一个 7440 亿参数的大模型,需要什么机器?
按常规思路,答案是几十万的 GPU 服务器,普通人想都别想。但 GitHub 上有个叫 colibrì 的项目给出了另一个答案 —— 一台 8GB 内存的旧笔记本,加一块够快的硬盘就行。目前在 GitHub 上有约 4 万 star,纯 C 语言写成,Apache 2.0 开源协议,README 有完整中文版。
代价要说在前面:慢,是真慢。纯 CPU 跑千亿级模型,每秒出几个字,跟云端 API 完全没法比。但它确实能跑,而且跑出来的结果和机房里的一模一样,不会偷偷给你换成”缩水版”。
如果你符合下面任何一条,这东西值得折腾一下:
- 想亲手摸一下顶级开源模型长什么样;
- 数据不想出本机,要求断网也能用;
- 想给自己写的应用接一个零成本的本地 AI 后端。
它是怎么把大象塞进冰箱的
要理解 colibrì,得先说清楚现在顶级开源模型的一个变化。GLM-5.2、Kimi K3、DeepSeek V4 这些模型基本都用了 MoE(混合专家)架构:模型里养着成百上千个”专家”,但每回答一个字,只有少数几个被叫起来干活。
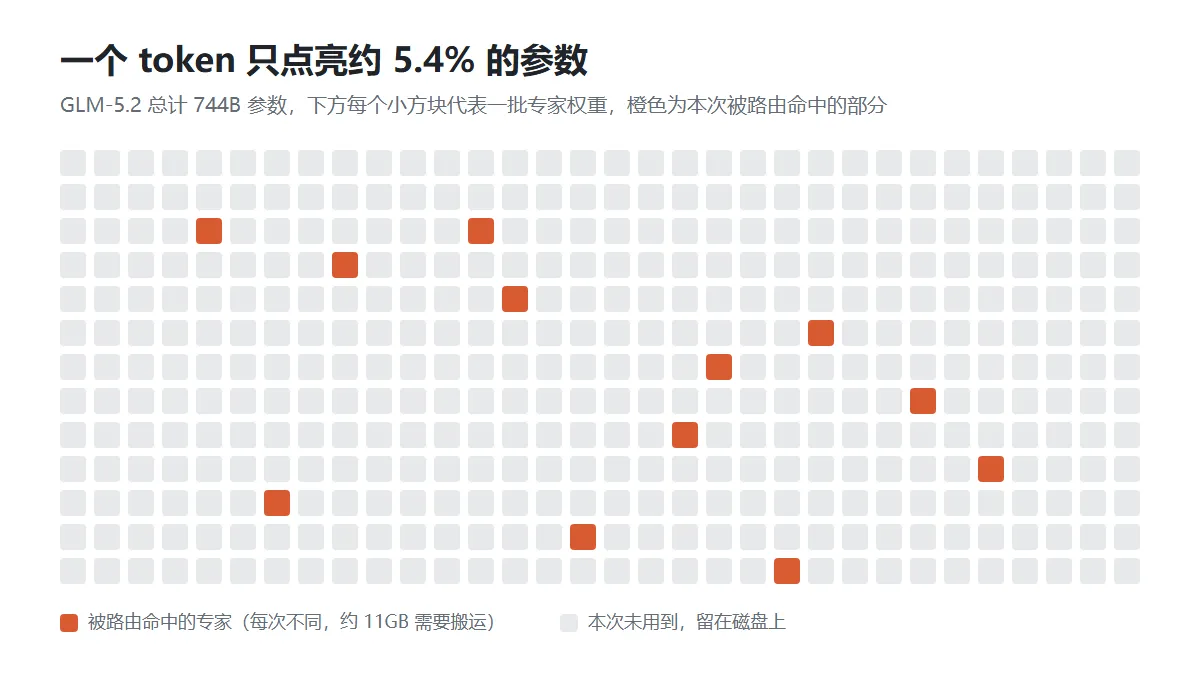
拿 GLM-5.2 举例:总参数 7440 亿,但每生成一个字真正参与计算的只有大约 5%,其中会变动的部分大概 11GB —— 就是那几个被点名的专家。
常规软件的做法是”整个模型塞进显存,塞不下就跑不了”。colibrì 换了个思路:模型不需要完整装进高速内存,它需要被放在对的地方。
- 常用的部分(注意力层、共享专家)留在内存里,随叫随到;
- 大部分专家躺在硬盘上,被点名了才读进来;
- 有显卡的话,最热门的一批专家放进显存,速度会快不少。
它还有个设计挺有意思:会记录你的对话习惯,把常用到的专家固定留在高速层里,用得越久越快。
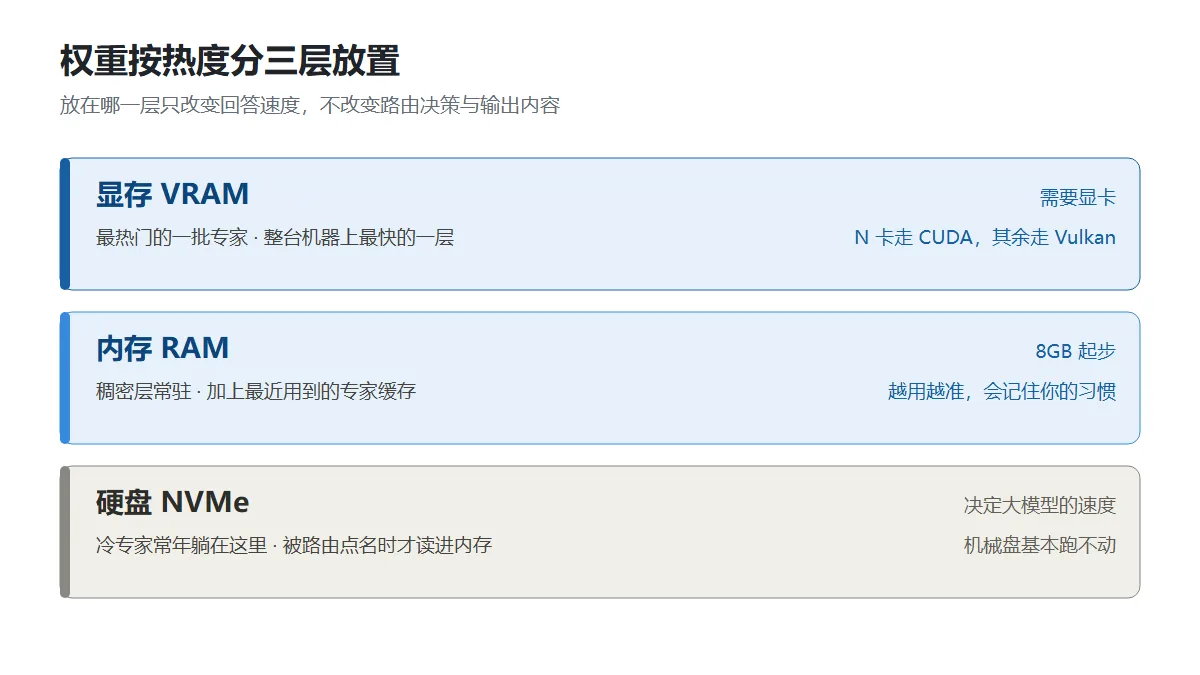
这里有一句官方承诺值得单独拎出来:专家放在硬盘还是显存,只影响回答的速度,不影响回答的内容。内存不够可以慢,但不会偷偷降低模型精度。在本地 AI 这块到处都是量化阉割的生态里,这种克制挺少见。
装上之后能干什么
别以为它只是个终端里打字聊天的小玩意,实际能玩的东西不少:
- 本地聊天:命令行或网页界面都行,断网可用,数据不出本机;
- 当接口给别的软件用:它同时提供 OpenAI 和 Anthropic 两种兼容接口,你现有的 AI 工具、编程插件改个地址就能接上;
- 看模型”怎么想的”:网页仪表盘里有个”大脑”页面,能实时看到这一刻哪些专家被点亮了 —— 想搞懂 MoE 是怎么回事,这个比看十篇论文直观;
- 让它做判断题:有个叫 System One 的接口,你给它几个固定选项,它返回每个选项的概率和把握程度,不会擅自编出列表以外的答案;
- 文生图:通过 Qwen-Image-2.1 引擎实现(注意这个模型是非商业授权,别拿去商用)。
安装教程:Windows 用户看这里
官方做了个一键脚本,会自动检测你的硬件、推荐跑得动的模型、断点续传下载、按需编译。整个过程跟装个普通软件差不多。
第一步:下载并解压
打开项目地址 https://github.com/JustVugg/colibri,点右上角绿色的 Code 按钮,选 Download ZIP,下载完解压到任意位置。
第二步:双击 START-HERE.bat
在解压出来的文件夹里找到 START-HERE.bat,双击运行。如果电脑上没装 Python,脚本会问你要不要帮你装,同意就行。
第三步:选模型,直接回车
脚本会检查你的内存、硬盘、CPU 和显卡,然后推荐一个装得下的模型。新手直接按回车用推荐值即可。
接下来是自动的:下载模型(支持断点续传,中断了再运行一次就会接着下)、按需编译引擎、启动服务、打开浏览器。全部完成后你会看到这样的地址:
网页界面:        http://127.0.0.1:8000/
OpenAI 接口地址: http://127.0.0.1:8000/v1
停止服务:        在这个窗口按 Ctrl+C
以后再用,直接再双击一次 START-HERE.bat 就行,不会重新下载也不会重新编译。
Linux 和 macOS 用户
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh
Linux 先补依赖:sudo apt install git python3 build-essential;macOS 需要先装 Homebrew,再 brew install libomp git python。
几个有用的启动参数
| 参数 | 作用 |
|---|---|
--list |
列出所有模型和本机配置的对照,看哪些能跑、哪些跑不动 |
--model 模型ID |
直接指定装哪个模型 |
--dir 路径 |
把模型放到别的盘(默认在用户目录下的 colibri-models) |
--no-gpu |
只用 CPU 跑,不碰显卡 |
--reconfigure |
换一个模型 |
选模型:别一上来就挑最大的
这是最容易劝退的一步。官方表格很细,这里挑几个典型的说一下(内存一栏,低于前一个数字跑不起来,达到后一个数字才能达到标注速度)。
小模型:能完整放进内存,速度还算正常
| 模型 | 要下多大 | 内存要求 | 实测速度 |
|---|---|---|---|
| Qwen3.6-35B(新手推荐) | 23 GB | 10 / 20 GB | 纯 CPU 每秒约 6 字;核显 9.9 字;独显可达 30 字 |
| Qwen3-Coder-30B(写代码专用) | 19 GB | 8 / 18 GB | 每秒 8–9 字 |
| OLMoE 7B(熟悉工具用) | 14 GB | 8 GB | 每秒 22–23 字 |
大模型:专家从硬盘读,速度看你硬盘
| 模型 | 要下多大 | 内存要求 | 实测速度 |
|---|---|---|---|
| DeepSeek V4 Flash(284B) | 167 GB | 16 / 32 GB | 32GB 内存时 0.93 字/秒;配 RTX 5080 约 1.5–1.6 字/秒 |
| MiMo-V2.6 Flash(309B) | 172 GB | 32 / 52 GB | 2.34–3.37 字/秒(纯 CPU) |
| Qwen3.8-Flash-Next(125B+51B) | 186 GB | 24 / 32 GB | 1.91–2.56 字/秒 |
| GLM-5.2(744B) | 429 GB | 16 / 24 GB | 25GB 笔记本冷启动 0.05–0.1;128GB 内存主机 1.83;6 张 RTX 5090 可达 9.0–9.2 |
| Kimi K3(2.8 万亿,最大) | 1.56 TB | 32 / 64 GB | 约 9.4 秒一个字 |
新手建议从 Qwen3.6-35B 开始。23GB 下载量、10GB 内存起步、每秒 6 个字,是唯一一个”装完就能正常聊天”的组合。想体验千亿参数,再考虑 GLM-5.2,但先把硬盘和耐心准备好。
实测速度一览
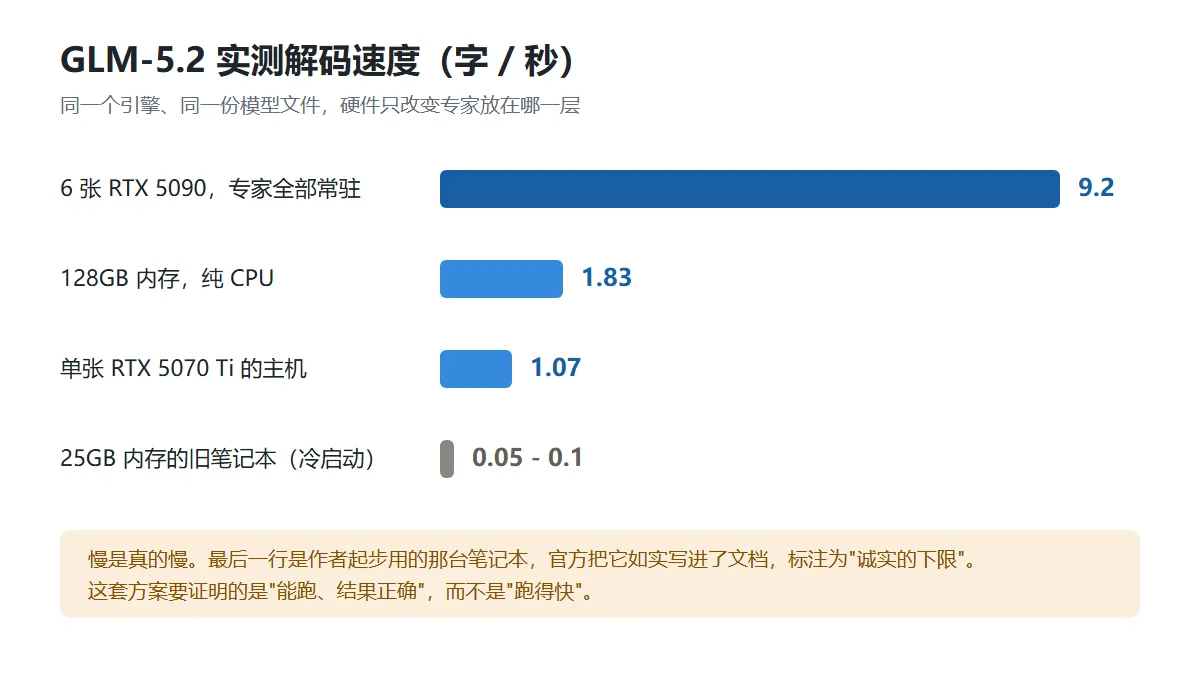
同一个引擎、同一份模型文件,硬件只改变专家放在哪一层。以 GLM-5.2 为例:
| 硬件 | 速度 |
|---|---|
| 6 张 RTX 5090,专家全部常驻 | 5.8–6.8 字/秒(优化后可达 9.0–9.2) |
| 128GB 内存纯 CPU | 热缓存 1.83 字/秒 |
| 单张 RTX 5070 Ti 的主机 | 1.07 字/秒 |
| 25GB 内存的旧笔记本(项目起点) | 冷启动 0.05–0.1 字/秒 |
几个容易踩的坑
- 模型文件版本别下错。GLM-5.2 必须用官方指定的 gs64 版本容器,老版的 per-row int4 镜像质量实测低约 9 个百分点,还会导致回答打转的 bug。
- 硬盘要留够,最好是 NVMe 固态。机械盘基本跑不动大模型,读取跟不上。
- WSL 里别把模型放在 /mnt/c 下面,比 Linux 原生磁盘慢好几倍。
- 下载中断不用慌,再运行一次同一个命令,会从已经下好的部分继续。
- 核显不一定更快。集成显卡和 CPU 共用内存,只有部分引擎有收益,小模型反而可能变慢,别手动乱开。
- Qwen-Image-2.1 是非商业授权,商用请注意避开。
和 Ollama、llama.cpp 有什么区别
- Ollama:主打开箱即用,跑的是几十 B 的小模型,省心;
- llama.cpp:通用推理引擎,稠密模型和中等规模 MoE 的主力;
- colibrì:专攻”超大规模稀疏模型 + 有限内存”,把硬盘当成推理管线的一部分来设计。
简单说:只想找个能聊天的本地助手,Ollama 省心得多;想知道自己那台旧电脑能不能”养”一个 7440 亿参数的模型,colibrì 是目前几乎是唯一的选择。
下载
项目主页(含源码、文档、中文说明):https://github.com/JustVugg/colibri
各平台预编译包:https://github.com/JustVugg/colibri/releases
Windows 用户记得顺手把 CUDA 包一起下(如果你用的是 N 卡),解压覆盖到主包上面,安装程序会自动选它。
项目是免费的,作者说如果觉得好用,去仓库点个 star 就是最大的支持。如果你在自己的机器上跑了测试,也欢迎把硬件配置和速度数据发到项目的 issue 里 —— 他们明确说,一个记录完整的失败比一个说不清来源的高速数字更有价值。
文章版权声明
1 原创文章作者:yueliang,如若转载,请注明出处: https://www.52hwl.com/118261.html
2 温馨提示:软件侵权请联系469472785#qq.com(三天内删除相关链接)资源失效请留言反馈
3 下载提示:如遇蓝奏云无法访问,请修改lanzous(把s修改成x)
4 免责声明:本站为个人博客,所有软件信息均来自网络 修改版软件,加群广告提示为修改者自留,非本站信息,注意鉴别
 微信扫一扫
 支付宝扫一扫