一句话看懂:Cloudflare 官方开源了一套给 AI 编码助手用的「安全审计技能包」,整个仓库只有 22 个文件、315KB,star 数却有 4.2 万。听起来很不搭——但读完它的文档你会发现,这 4.2 万 star 买的不是软件,是 Cloudflare 拿真漏洞喂出来的方法论。
项目地址:https://github.com/cloudflare/security-audit-skill
先泼冷水:它不是扫描器
点进仓库之前,很多人以为这是个安全扫描工具。不是。里面没有任何扫描引擎、规则库或者漏洞特征——核心资产是 15 个 Markdown 文档 + 2 个零依赖校验脚本。它要安装在 Claude Code、Codex CLI 这类能编排子任务的编码助手里,把你的 AI 助手「训练」成一个按 Cloudflare 流程干活的安全审计员。
所以那句「22 个文件 4.2 万 star」反差不成立:文档型资产本来就不需要几万行代码。但有两个数字值得你知道——这个仓库一个 release 都没发过,最后提交停在 2026 年 9 月 14 日。对软件来说这算停更预警,对一套文档来说影响没那么大:方法论不会过期,只是你要接受它不会跟着新框架自动进化。
它治的是 AI 审计的三个通病
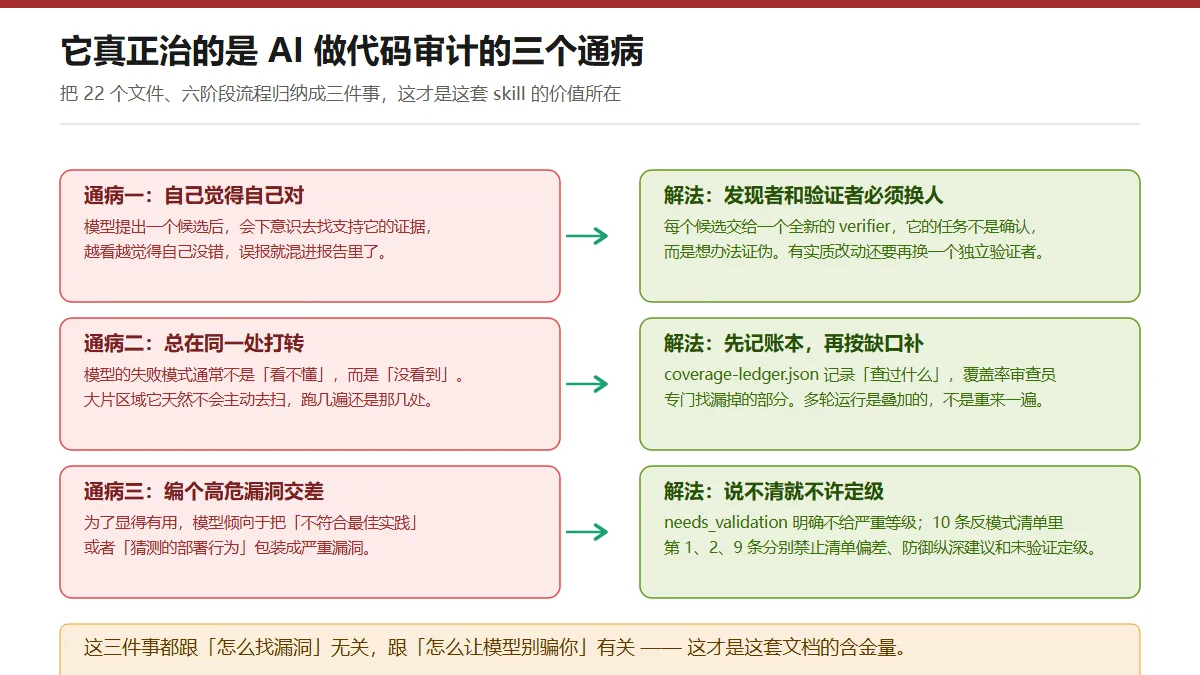
用过 AI 找漏洞的人都知道,直接让模型「帮我审一下这段代码」效果很差。差在哪?这个项目把病因和解法写得非常透:
通病一:自己觉得自己对。模型提出一个候选漏洞后会下意识找支持证据,越看越像真的。解法很硬:发现漏洞的 agent 和验证的 agent 必须不是同一个,验证者的任务不是确认而是证伪;记录有实质改动后还要再换一个独立验证者。整套流程里「对抗式验证」出现了三次,可见作者被误报坑过多少次。
通病二:总在同一处打转。模型的失败模式通常不是「看不懂」,而是「没看到」——大片区域它天然不会主动去扫。解法是整个流程我认为最值得抄的设计:覆盖率账本。每次审计先维护一个 coverage-ledger.json,记录「查过什么、怎么查的、结论是什么」,覆盖率审查员专门找账本上的缺口,下一轮 hunter 从缺口出发。多轮运行是叠加的,不是从头再来。
通病三:编个高危漏洞交差。为了显得有用,模型倾向于把「不符合最佳实践」「猜测的部署行为」包装成严重漏洞。解法见下一节。
三档判定:有没有「我没证实」这一档,是分水岭
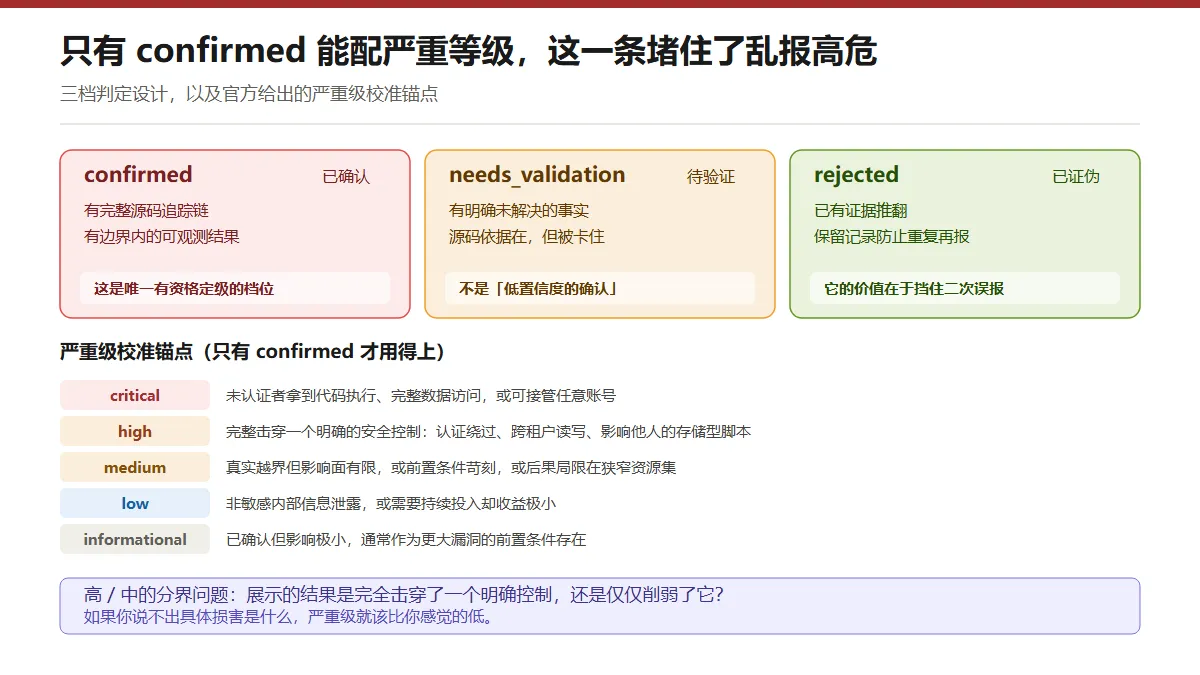
所有候选漏洞只能落进三个档位:confirmed(完整源码追踪链 + 边界内的可观测结果)、needs_validation(有明确未解决的事实,不给严重等级)、rejected(已被证伪,保留记录防止重复再报)。
关键在第二档。needs_validation 不是「低置信度的确认」,它意味着「源码依据在,但被某个具体事实卡住了」——而且明确不许配严重等级。这一条直接断了模型「编个高危来交差」的路:说不清就不许定级。
配套还有一份 10 条的反模式清单,翻译几条感受一下:
- 「偏离安全检查清单」本身不算漏洞;
- 防御纵深建议不算漏洞——如果 A 层已经挡住了攻击,缺 B 层只是加固笔记;
- 不许给未验证的记录定级;
- 不许在验证完成前先写报告,报告和 JSON 不许互相矛盾。
顺带说一句,官方给的严重级校准锚点也很值得单独存下来,尤其这句:「高 / 中的分界问题是——展示的结果是完全击穿了一个明确控制,还是仅仅削弱了它?如果你说不出具体损害是什么,严重级就该比你感觉的低。」这句话对所有做代码安全的人都适用,跟用不用 AI 无关。
六阶段流程怎么跑
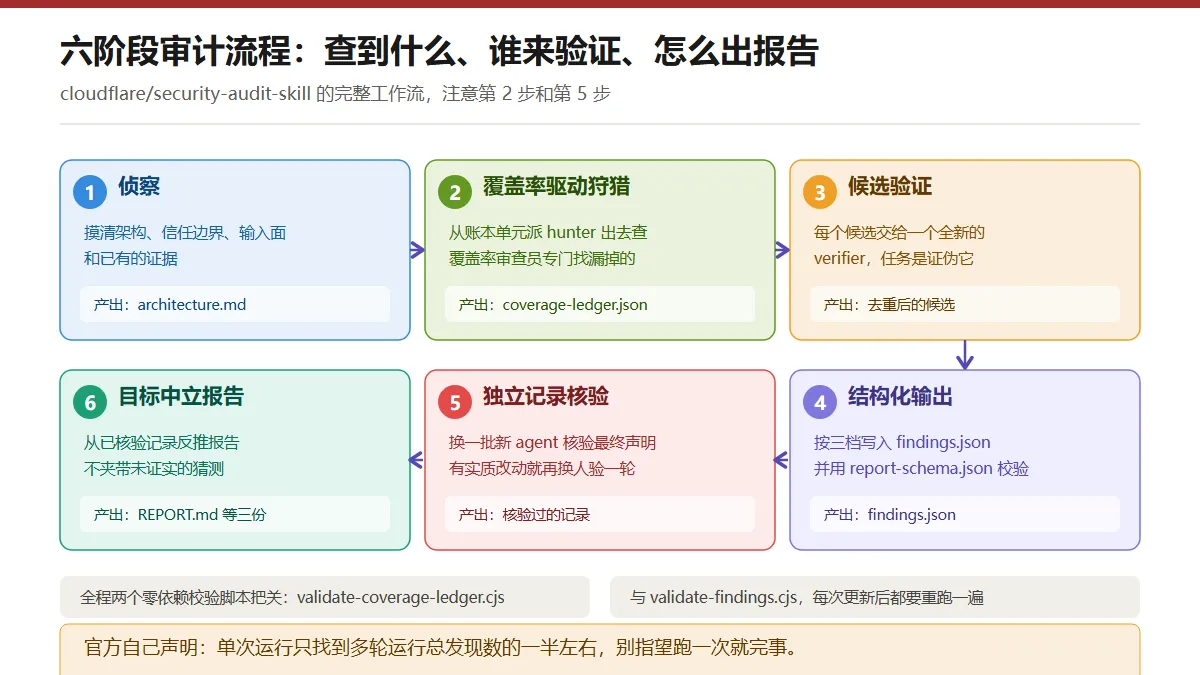
完整审计分六步:侦察(画架构和信任边界)→ 覆盖率驱动狩猎 → 候选验证 → 结构化输出 → 独立记录核验 → 出报告。全程两个零依赖 Node 脚本把关:账本每次更新后跑 validate-coverage-ledger.cjs,发现记录更新后跑 validate-findings.cjs——用机器校验而不是靠模型自觉,这也是它比一般「提示词合集」严谨的地方。
还有一句官方声明必须原样告诉你:「在我们的测试中,单次运行只找到重复运行总发现数的一半左右。」所以它设计的用法是反复跑、增量跑(每次会参考之前的账本和发现,只补缺口、重验改过的代码),适合长期挂在流程里,不适合「跑一次出报告交差」。
上手三步,但门槛别低估
安装就一行(需要 Node.js):
npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit然后在你想要审计的代码库里打开编码助手,说一句 security audit this codebase 就会自动触发。想装成全局的加 --global。
但 README 的 Requirements 一节写得很诚实,三个硬性要求:
- 能跑并行子 agent 的编码助手——这是隐形成本,商业助手订阅费加上一次完整审计的 token 消耗不便宜,文档里甚至专门有一节讲怎么设成本预算;
- Node.js——跑那两个校验脚本;
- OS 级沙箱——禁外网、白名单环境、资源限制、只许写指定目录。没有这些控制,流程会把候选保持为 needs_validation 而拒绝执行目标代码。
第三条最容易被忽略。它意味着「跑一次审计」不是装个包就行,你得给它一个隔离环境(容器或虚拟机)。反过来看,这个要求本身就说明作者想得很清楚:让 AI 在你的代码上跑构建、测试甚至模糊测试,不加沙箱就是在裸奔。
和 CodeQL、Semgrep 是什么关系
互补,不是替代。传统 SAST 靠规则匹配,确定性强、可复现,但找不到业务逻辑漏洞——比如「这个接口忘了校验 tenant_id」这种跨租户问题,规则库里没有对应的规则。而这套 skill 靠语义理解,恰恰擅长这类需要「理解意图」的漏洞。代价是不确定、要验证、费钱。合理用法是:SAST 常态化跑,AI 审计定期跑、重点跑。
合规边界:只能审你自己的代码
必须说清楚:这套东西是防守方工具。设计上就限定了目标——反模式清单明确禁止「在真实或共享环境测试」,沙箱要求禁外网,且不许产出持久化、后渗透材料。它的定位是审计你拥有或被授权审计的代码仓库,不是对别人系统做渗透测试。后者在国内有明确法律风险,别动歪心思。
适合谁
有编码助手订阅、想给自己项目做安全体检的开发者;想把安全审查挂进流程、能接受多次运行成本的小团队;以及想学习「怎么设计可信 AI 工作流」的人——就算你一条审计都不跑,把 SKILL.md 和那 10 条反模式读一遍,也比大多数 AI 安全入门文章有用。不适合想「一键扫描出报告」的人:它比任何扫描器都费心,但换来的发现质量也不在一个档次。
下载
仓库主页:github.com/cloudflare/security-audit-skill(MIT 协议)
配套博客:Build your own vulnerability harness(讲这套 skill 如何长成 Cloudflare 内部的漏洞挖掘系统)
文章版权声明
1 原创文章作者:yueliang,如若转载,请注明出处: https://www.52hwl.com/118300.html
2 温馨提示:软件侵权请联系469472785#qq.com(三天内删除相关链接)资源失效请留言反馈
3 下载提示:如遇蓝奏云无法访问,请修改lanzous(把s修改成x)
4 免责声明:本站为个人博客,所有软件信息均来自网络 修改版软件,加群广告提示为修改者自留,非本站信息,注意鉴别
 微信扫一扫
 支付宝扫一扫